(시사캐스트, SISACAST= 이아름 기자)
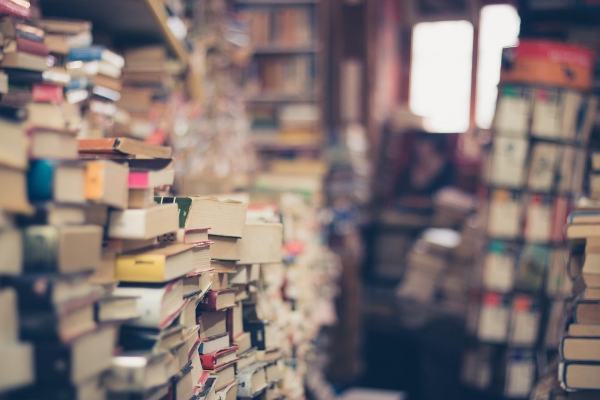
최근 글로벌 서점가에 ‘큰손’이 등장했다. 그런데 행태가 수상쩍다. 순수한 독서가 목적이 아닌 것처럼 보인다. 베스트셀러도, 특정 작가의 책도 찾지 않아서다. 대신 분야를 가리지 않고 가능한 한 많은 종류의 책을 한 권씩 달라는 주문을 하고 있다. 인공지능(AI) 학습용 데이터를 무차별적으로 긁어모으려는 테크 기업이 배후에 있다는 의혹이 짙어지고 있는 이유다.
한국에서도 비슷한 움직임이 포착됐다. 교보문고에는 올해 미국과 영국 등 해외 업체 10여 곳에서 한국어 도서 약 10만 종을 한 권씩 사고 싶다는 문의가 들어왔다. 알라딘에는 지난달 한 외국 업체가 한국어 중고책 1000만 원어치를 무작위로 구매하겠다고 제안했다.
두 회사 모두 최종 사용처가 확인되지 않은 탓에 거래를 진행하지 않았다. 두 곳 모두 최종 사용처가 불투명해 거래의 문을 닫았지만, 정황상 AI 학습용 데이터 확보를 위한 싹쓸이일 가능성에 무게가 실린다.
의심을 키운 건 이미 이런 방식으로 책을 확보한 AI 기업이 있기 때문이다. AI 모델 클로드(Claude)를 개발한 앤트로픽(Anthropic)은 2024년 ‘프로젝트 파나마(Project Panama)’를 가동했다. 수백만 권의 종이책을 사들인 뒤 책등을 잘라 페이지를 스캔하고 디지털 파일로 만드는 작업이었다.
스캔이 끝난 종이책은 폐기됐다. 미국 법원 문서에 따르면 앤트로픽은 이를 위해 수천만 달러 규모의 비용을 투입했다.
여기엔 한국 책도 포함됐다. 최근 선적 자료를 분석한 보도에 따르면 앤트로픽이 도서 조달업체를 통해 한국에서 확보한 책은 165.69t에 달한다. 권당 400g으로 환산하면 약 41만 4000권이다. 구체적인 도서 목록이 공개되지 않아 실제 몇 종의 한국어 책이 AI 학습에 사용됐는지는 확인되지 않았다.
AI 기업이 인터넷을 놔두고 굳이 종이책까지 찾아 나선 데는 이유가 있다. 웹에는 이미 AI가 만든 글이 빠르게 늘고 있다. 반면 과거에 출간된 책은 출판사의 편집과 교정을 거친 ‘인간이 쓴 데이터’다. 인터넷에 전문이 올라오지 않은 전문서적이나 오래된 지역·문화 자료도 적지 않다.
이미 디지털화한 데이터를 상당 부분 학습한 AI 기업 입장에서는 종이책이 새로운 고품질 데이터 창고가 된 셈이다. 영국과 아일랜드, 호주 등의 중고서점에서도 분야가 제각각인 책을 대량으로 사들이는 주문이 잇따르고 있다.
AI 업체가 서점가의 큰손이 된 것 자체는 문제가 될 게 없다. 쟁점은 ‘소유권’과 ‘저작권’의 충돌이다. 서점에서 돈을 주고 책이라는 실물을 샀다고 해서, 그 안의 활자를 AI 학습용으로 마음대로 뜯어고칠 권리까지 쥐는 건 아니기 때문이다. 책을 소유하는 것과 저작물을 무단 복제해 알고리즘의 일부로 쓰는 행위는 엄연히 다른 문제다.
한국에서는 아직 뚜렷한 법적 다툼이 벌어지지 않았다. 한국저작권위원회에 따르면 이용 목적과 저작물의 성격, 사용 범위, 원작 시장에 미치는 영향 등을 따져 공정이용 여부를 개별적으로 판단해야 한다. 정당하게 값을 치르고 책을 샀더라도, 그 안에 담긴 텍스트를 AI 학습에 통째로 밀어 넣을 권리까지 덤으로 따라오는 건 아니라는 얘기다.
그간 AI 기업의 쟁탈전은 웹페이지와 이미지, 코드 등 온라인 데이터 긁어모으기에 집중됐다. 하지만 쓸 만한 디지털 데이터가 바닥을 드러내면서 쩐의 전쟁은 이제 서점과 창고, 낡은 책장으로 번지고 있다.
한 AI 업계 관계자는 “온라인상에서 저작권 분쟁 없이 고품질 학습 데이터를 구하기가 갈수록 하늘의 별 따기가 된 상황에서 전문가의 손을 거쳐 정제된 종이책은 훌륭한 데이터 창고”라며 “디지털 데이터 고갈이 심화할수록 테크 기업들의 실물 책 싹쓸이 사례는 훨씬 더 늘어날 것”이라고 짚었다. AI 시대, 낡은 종이책이 가장 치열한 전략 자산으로 부상했다는 얘기다. [시사캐스트]